Google пропонує фазу сну для ШІ, який продовжує вчитися
Дослідники відокремлюють засвоєння інформації від її закріплення. Результат на довгому контексті вражає, але умови навчання не менш важливі.
ШІ та технології
Читати статтю

Дослідники відокремлюють засвоєння інформації від її закріплення. Результат на довгому контексті вражає, але умови навчання не менш важливі.
Показано 58 матеріалів
Дослідники відокремлюють засвоєння інформації від її закріплення. Результат на довгому контексті вражає, але умови навчання не менш важливі.
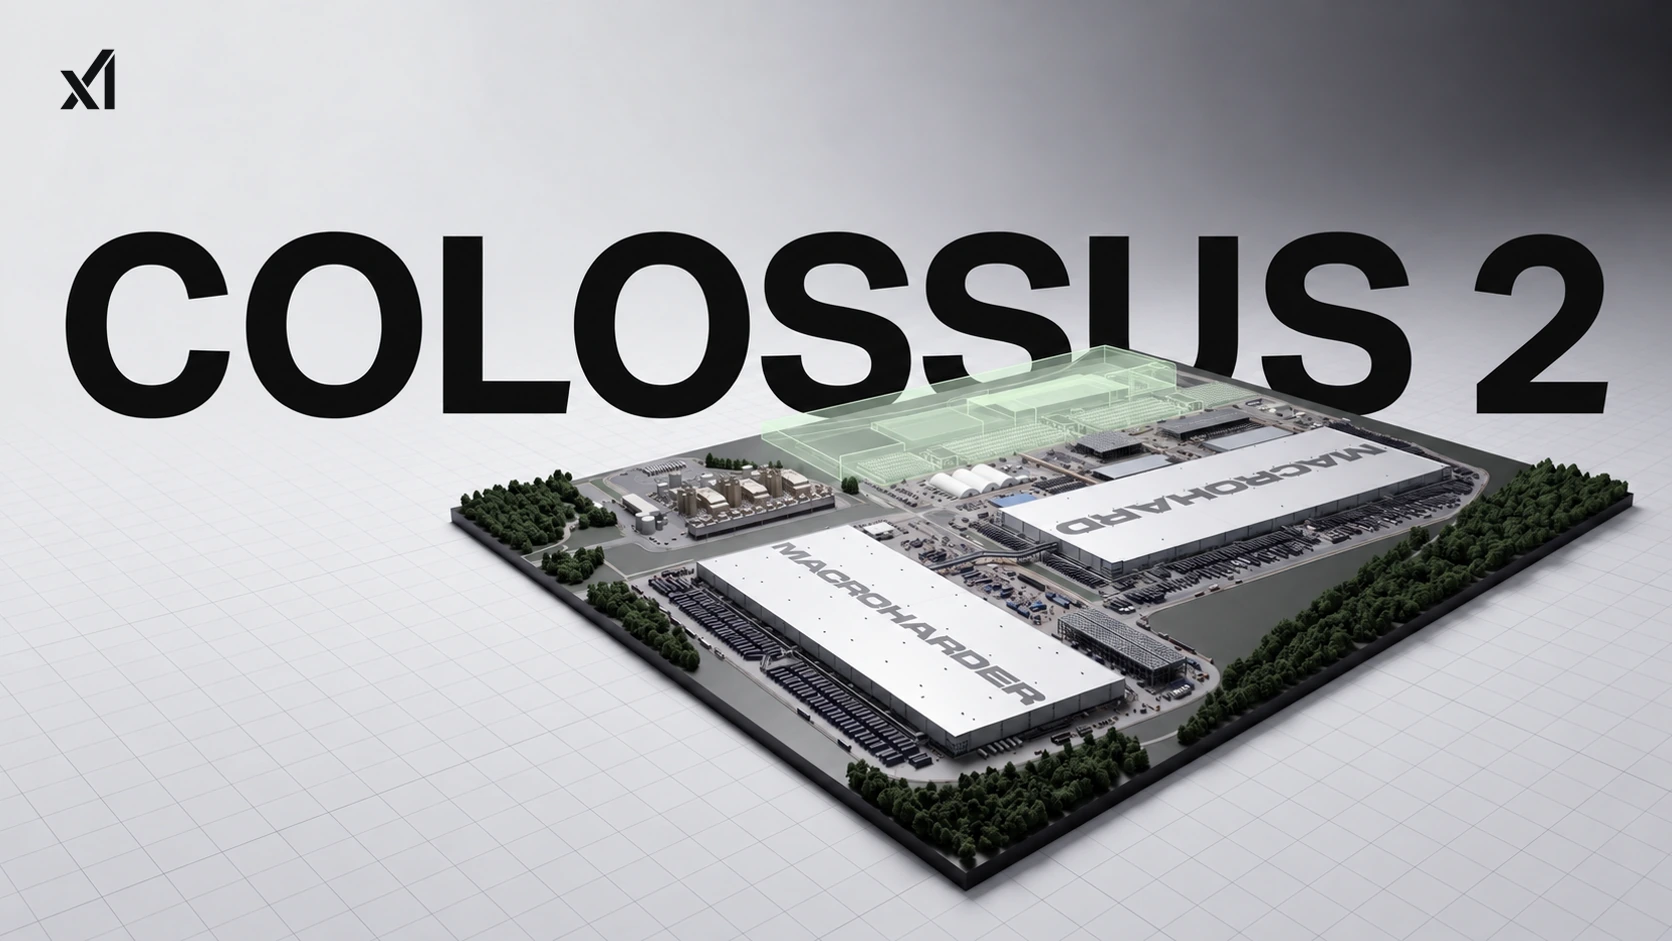
Пізніше уточнення дає близько 1,19 млн GPU на кампусі. Арифметика сходиться; введення в роботу, енергоспоживання й обіцянка кращого ШІ — окремі питання.
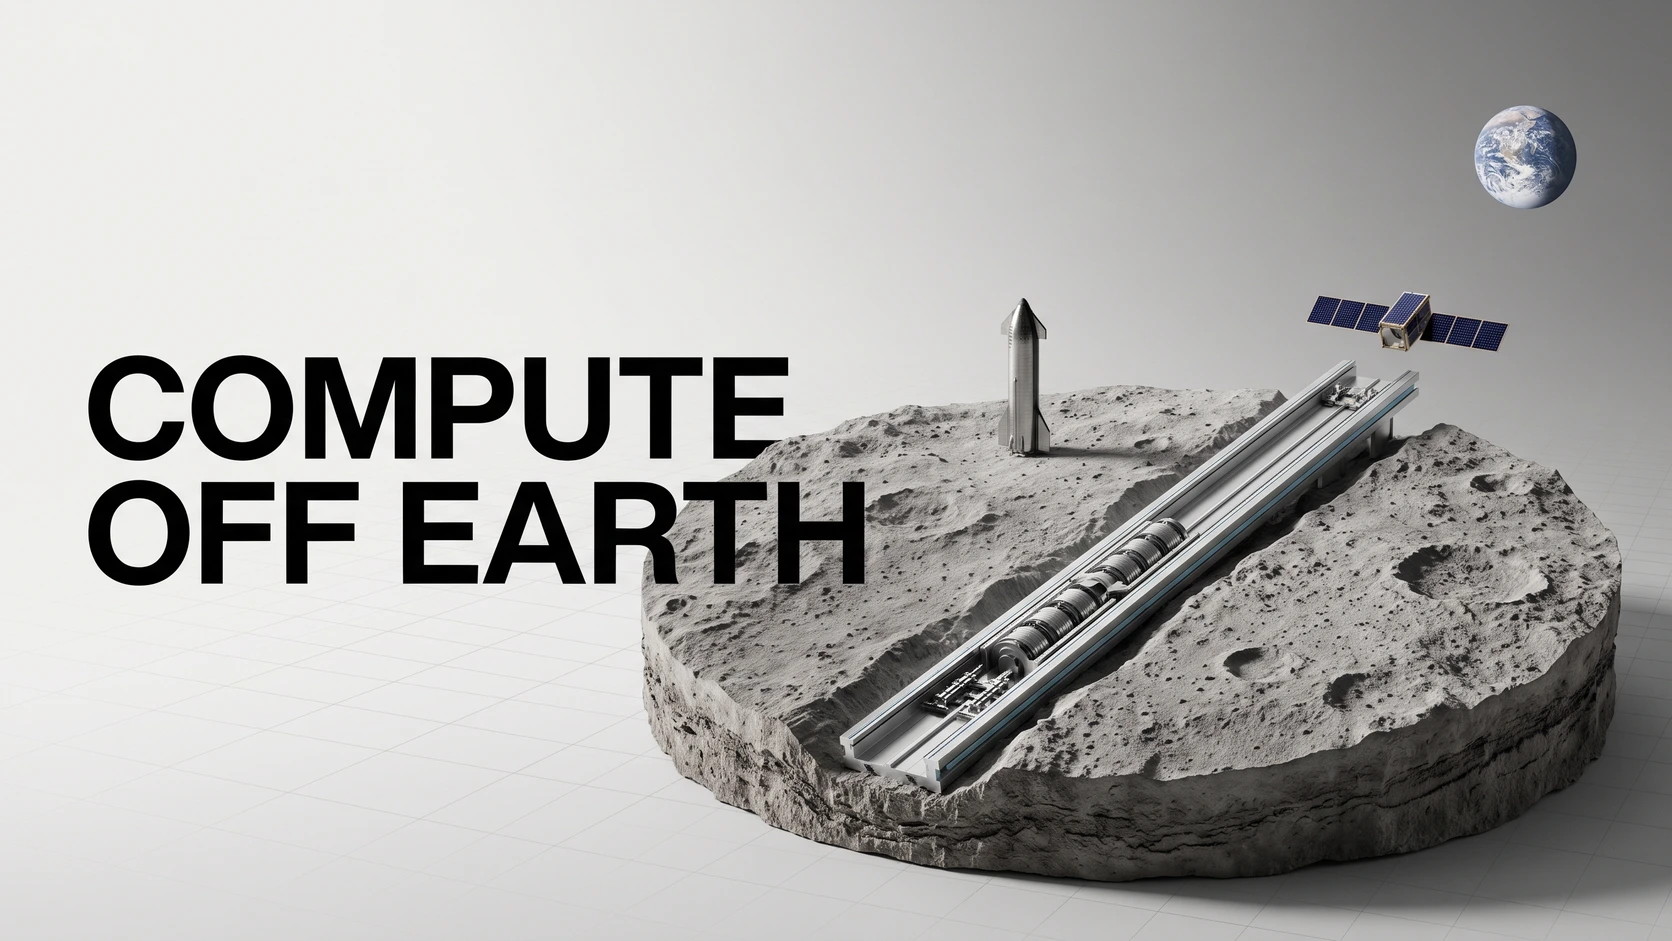

Маск очікує, що наприкінці 2028 року щомісячне нарощування орбітальних обчислень випередить наземне. Значно масштабніший місячний задум потребує заводів, електромагнітних прискорювачів і промислової системи, яку ще належить створити.
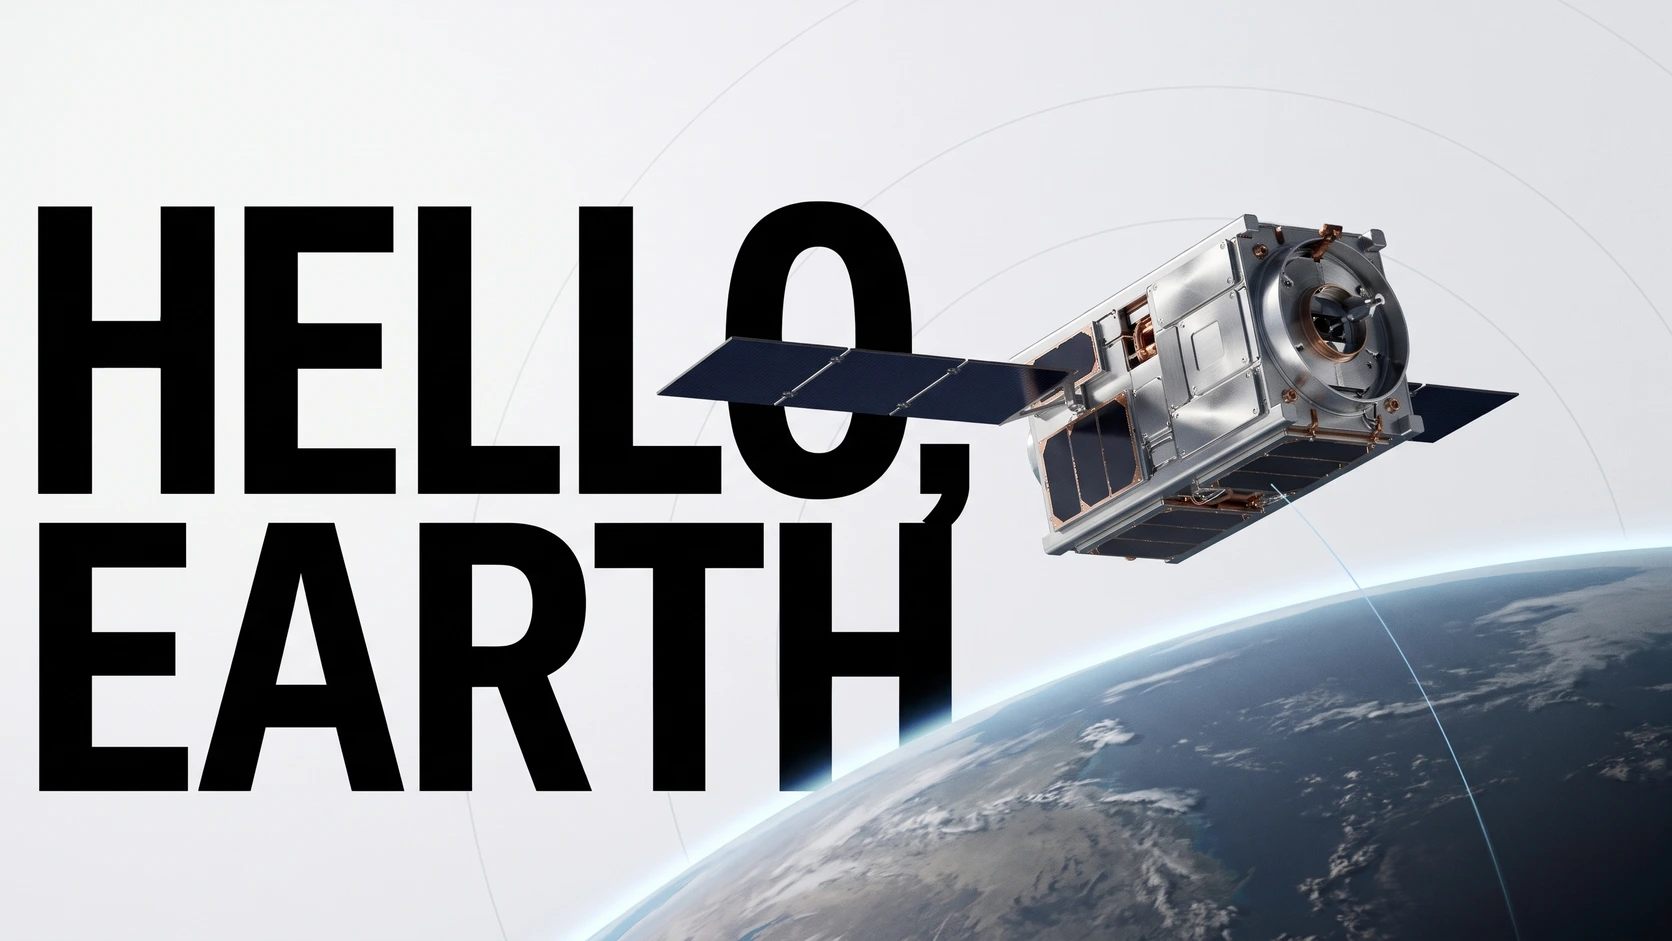

TPU на експериментальному супутнику Google обробив запит і передав відповідь на Землю. Щоб перетворити цей обмін на корисну обчислювальну систему, доведеться впоратися з теплом, радіацією, лазерним зв’язком і вартістю запусків.
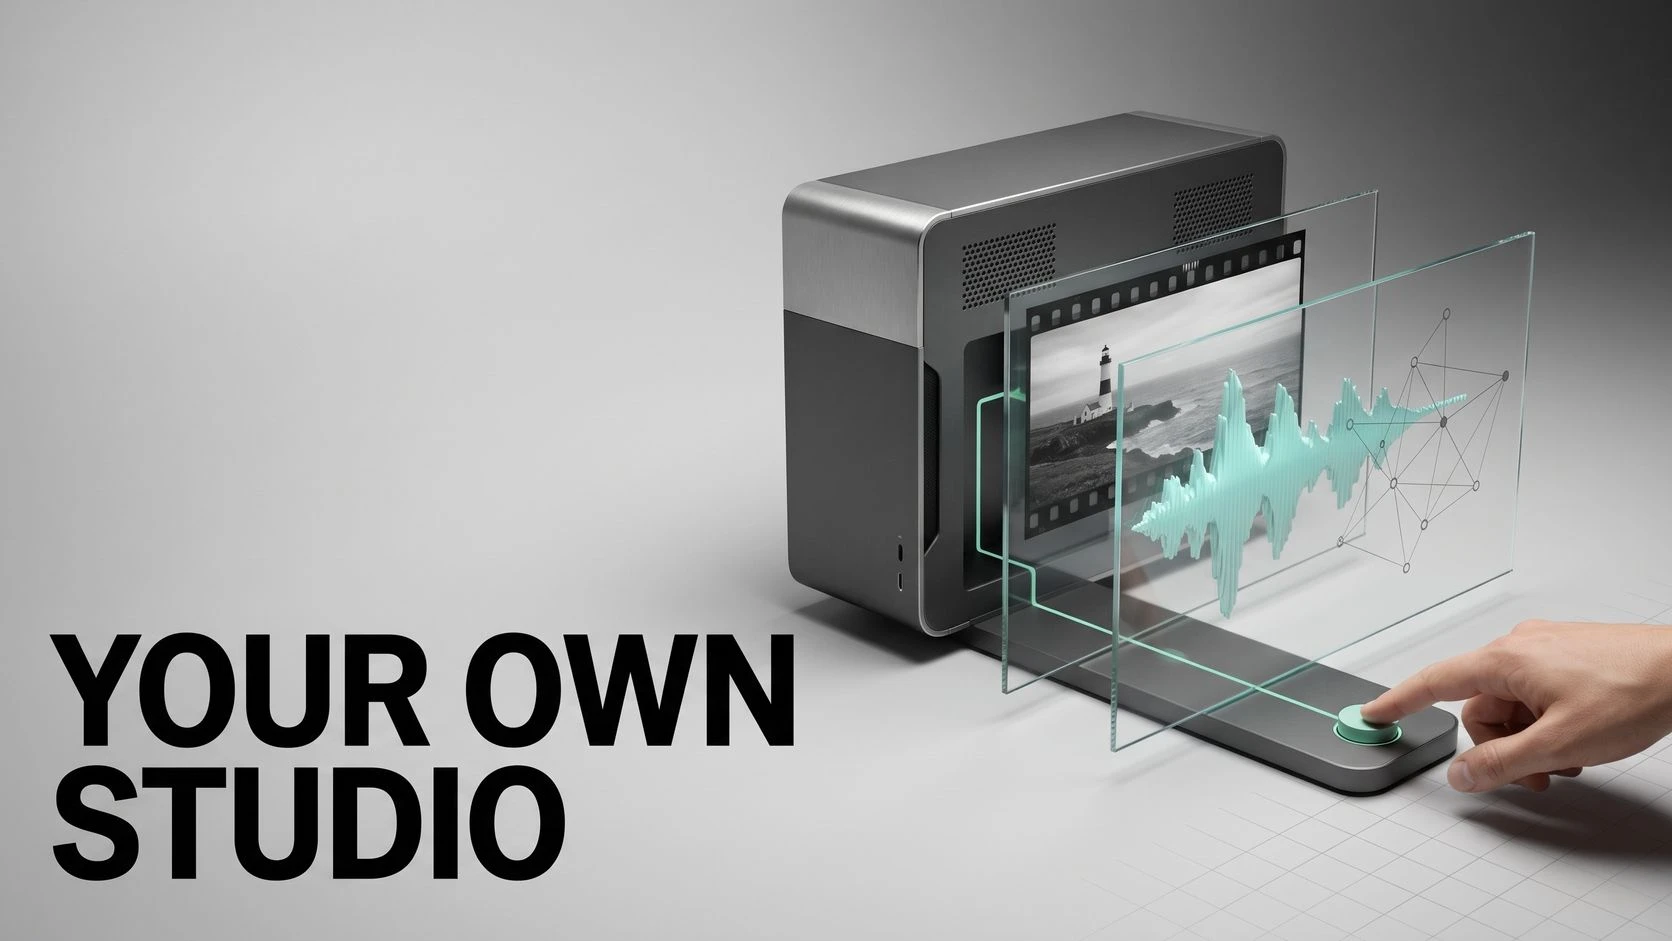

Keys і Сем Вассерман об’єднують локальні інструменти для створення кіно в одному каталозі з пошуком. Розбираємося, що стоїть за числом 61 і який комп’ютер для цього потрібен.
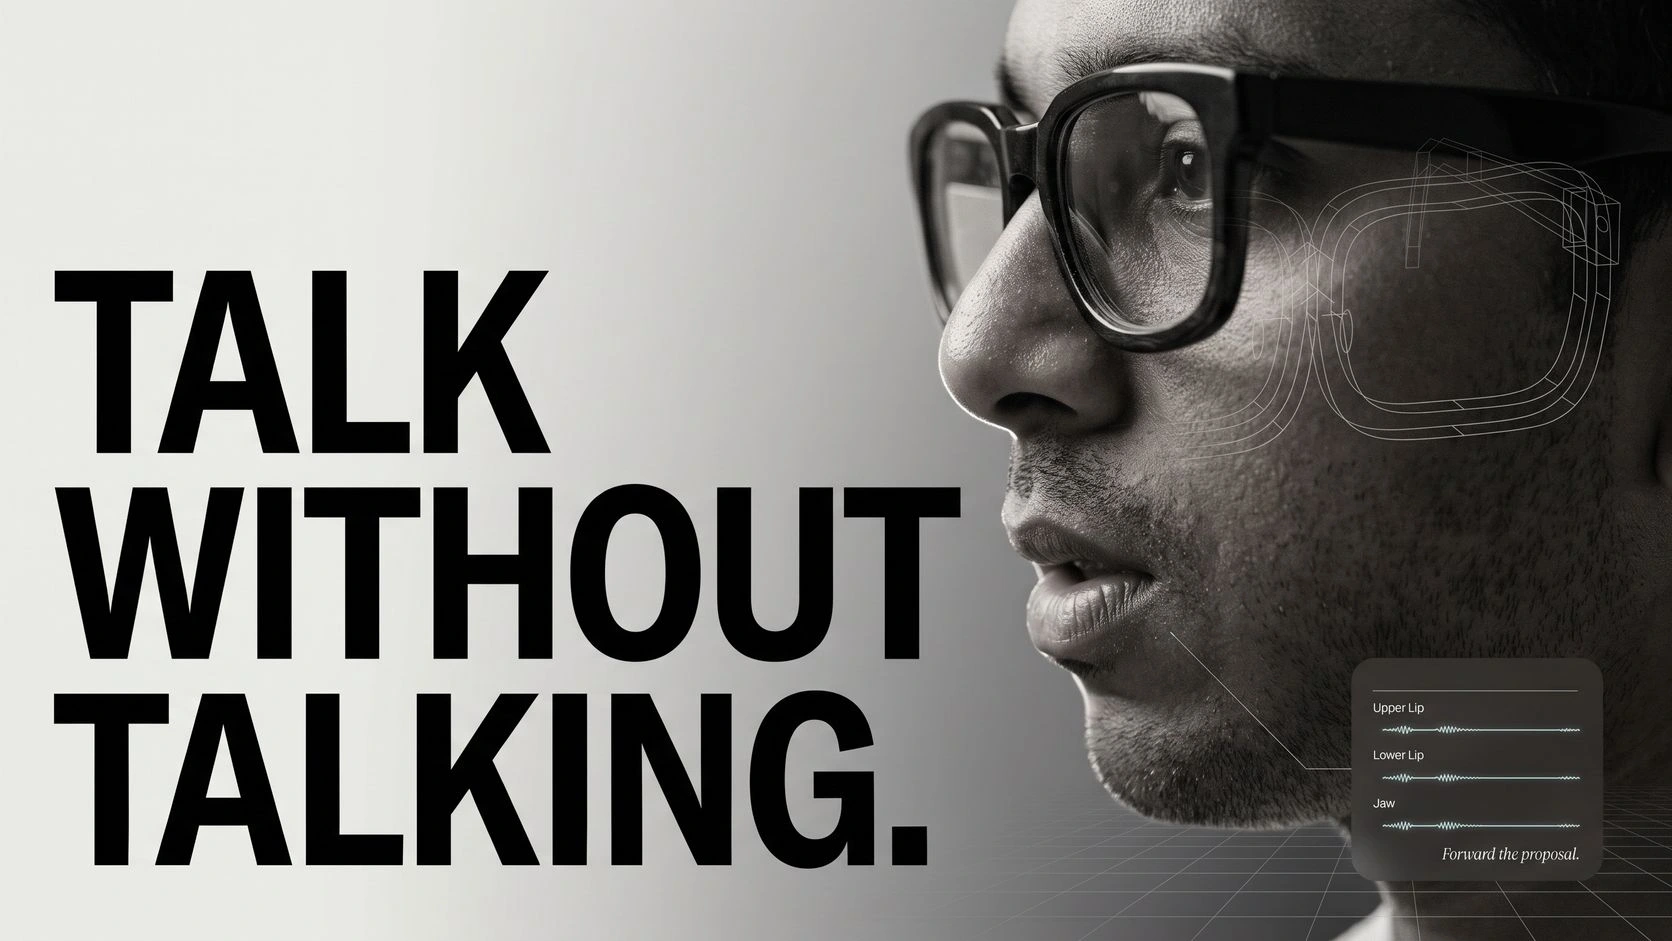

Вимовляти слова без звуку — і отримувати текст на комп’ютері. Subvocal заявляє про швидкість понад 200 слів за хвилину. Ідея приваблива, проте публічна демонстрація залишає відкритим питання точності.
Тариф Anthropic за $200 дає перевіреним акаунтам більше свободи працювати інтенсивніше. Що саме змінилося, як відбувається перевірка і які обмеження залишаються.

Модель світу з відкритими вагами реагує на нові вказівки під час розвитку сцени. Нове порівняння Tencent дає привід розібратися, що система пам’ятає, коли камера повертається назад.

Pika поєднала швидшу відеомодель з окремими звуковими доріжками та вагами для завантаження. Найцікавіше — що саме доступне в кожній версії.

Відео з геймплеєм може стати відправною точкою для інтерактивного проєкту. Важливо розрізняти створення гри й експорт реклами.

Збільшення залежить від вашого попереднього ліміту. Оновлена документація OpenAI пояснює різницю між обсягом роботи агентів і кількістю повідомлень у Chat.

Що тісніші зв’язки між творчими інструментами можуть змінити в роботі над фільмом — і що перевірити перед зміною підписки.

Carbon випереджає Argon в усій таблиці Google. Приріст суттєвий, перевага над конкурентами нерівномірна, а першими доступ отримають відібрані фахівці з кіберзахисту.

Дослідження NVIDIA отримало окремий реліз із моделями для людського скелета й робота. В основі — керування через пози; демонстрація в Unreal Engine відрізняється від пакета для завантаження.

NVIDIA представляє модель на сцені з комедії 1940 року: вона розпізнає записане мовлення, позначає мовців і перекладає. Складність — правильно поєднати ці завдання.

Нова студія коротких серіалів від ByteDance об’єднує роботу навколо згенерованого відео. Найцікавіше починається, коли перший монтаж уже готовий.

Траєкторія камери, набір референсів, процес, який варто повторити. Runway дозволяє творчим командам створити інтерфейс під власний спосіб роботи.

Змінюється сигнал світлофора. Відгукується двигун. Нова модель світу від Google реагує, поки ви перебуваєте всередині сцени. Що це змінює для кіно, ігор і складного завдання — зберігати цілісність вигаданого світу.

Ідея в ChatGPT, відеочернетка, далі — вебредактор CapCut. Анонсована інтеграція змінює початок роботи над відео. Листопадова бета має показати, наскільки зручним буде перехід між інструментами.

Крижана гавань, робоча 3D-сцена й несподівано чесне порівняння з Claude. Новий Kimi обіцяє більше, ніж вдалу відповідь: результат, який можна розвивати далі. Розбираємо, що підтверджують джерела.

Block стверджує, що її нова голосова модель навчалася лише на людських розмовах. За виразними демо стоять три різні заяви: навчання на мовленні, одночасне слухання й говоріння та локальний запуск. Розбираємо, що означає кожна.

Tesla повідомляє про початкове нарощування виробництва Optimus у Фрімонті. Що цей етап означає для робота — і чому він ще не дає відповіді, коли гуманоїди стануть звичними працівниками.

Нова модель Canva планує композицію перед створенням зображення. Її амбіція виходить за межі красивої картинки: ієрархія, читабельний текст і можливість продовжувати роботу над результатом.

Chimera поєднує мовлення Eleven v4 з відео Seedance 2.5. Її привабливість — коротший шлях від зображення персонажа й репліки до виконання на екрані. Її межі — можливості короткого згенерованого ролика.

Claude Duet може приносити роботу ще до вашого запиту. Попередня версія Anthropic ставить практичне питання: скільки ініціативи доречно давати програмі, яка читає підключені застосунки й діє від вашого імені?

Обличчя, продукт, кімната — і все, що відбувається між ними. HeyGen Video розширює завдання від ведучого, який промовляє текст, до цілісного плану. Тож увага до взаємодії, звуку й послідовності деталей стає ще важливішою.

Model 1 обіцяє зібрати ціле відео з одного завдання. Та найцікавіше починається після першого вдалого плану: чи збереже наступний його сенс і чи витримає фільм режисерські правки?

ElevenLabs переходить від генерації мовлення до ведення розмови. Mini та Max поєднують слухання, відповідь і голос; швидкість — лише одна з умов, за яких цей обмін працює.

Десять секунд відео приблизно за дванадцять секунд генерації. Розбираємо реліз BFL × fal: сюрреалістичний вестерн, звук, десять ключових кадрів, справжній зміст «поділяє перше місце» та цінність швидких повторних спроб для режисера.

Сцена приблизно за секунду привертає увагу. Можливість повернутися до того самого світу з іншого ракурсу — важливіша історія. Розбираємо JST-2: презентаційний ролик, оцінювання персонажів і руху розробником, Gaussian splats, тарифи API та межі поняття «physics-native».

Glimpse повертається до відео, перш ніж відповісти. Приклади запуску ставлять оманливо просте запитання: рухався об’єкт, повернулася камера чи змінився план?

Meta демонструє роботу своєї моделі з відкритими вагами в DaVinci Resolve. Приклад поєднує розуміння матеріалу з діями в програмі, а апаратні показники пояснюють вимоги локального запуску.

Зберегти зображення, яке нарешті вдалося. Нова звукова модель Mirelo обіцяє прибрати зайву музику й заново озвучити сцену, зберігши діалоги. Та що саме переживе цю обробку?

Одна кімната, два ракурси — і модель, яка допомагає побудувати сцену за ними. Публічний запуск Argon приніс амбітні творчі процеси, спільний бюджет у мільйон токенів і бенчмарки зі складнішою історією, ніж «найкращий ШІ».

Паперовий літачок перетинає згенеровану кімнату. За командою з’являється ложка. Далі демонстрація переходить до кіно. Показ моделі світу ByteDance ставить цікавіше запитання за якість чергового ШІ-ролика: чи можна режисувати те, що станеться далі?

У демонстрації Meta візуальні референси стають кухнею, у якій можна грати. За привабливим результатом — агент для програмування, мільйон токенів контексту й важлива різниця між створенням світу та розумінням його простору.

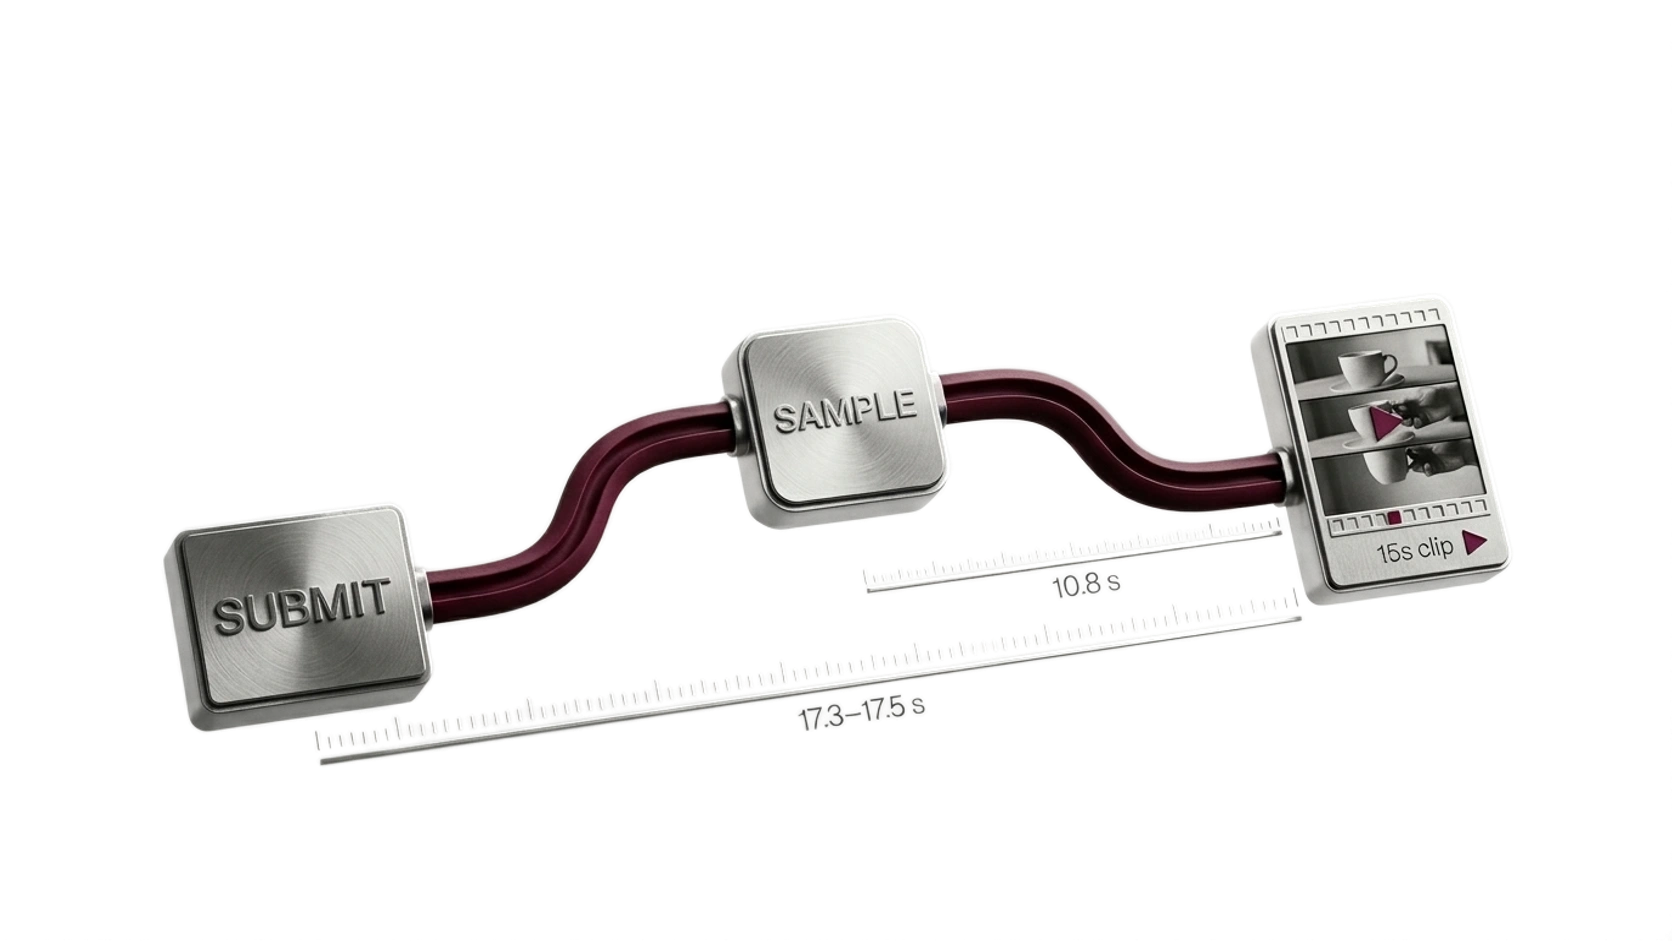
П’ятнадцятисекундний ролик і два різні виміри часу. ComfyStreamerH3 показує, чому швидкість генерації та очікування готового відео потрібно вимірювати окремо.

Brand Kit об’єднує візуальні референси та правила бренду й робить їх доступними в інструментах ElevenCreative. Зміна стосується брифу: менше потреби відновлювати той самий контекст для кожного запиту.

Google розширює доступ до детектора водяних знаків. Позитивний результат може виявити підтримуваний сигнал ШІ; його відсутність не доводить, що файл повністю створила людина.

OpenAI додає елементи керування до відповідей ChatGPT. Важливо, що читач може змінити — і які припущення інтерфейс робить видимими.

Новий інструмент Anthropic працює з кодом, текстом, графіками й фігурами. Його цінність — у тому, що можна змінити після першої версії.

Кадр уже вдався. Просиш про одну правку — і ризикуєш втратити обличчя, продукт або деталь, яка подобалася. Нова модель Google обіцяє точніше редагування. Перші опубліковані порівняння показують і прогрес, і підступ.

Хвилина розмови. Потім з’ясувалося: співрозмовник на екрані був ШІ. Розбираємо дослідження Tavus із 54 учасниками, демонстрації Griffin і різницю в часі реакції за бенчмарком NVIDIA.

Два референси персонажів, одне зображення локації та 30 секунд бійки. Офіційний hands-on Джонсона Шенга ставить цікаве питання: чи залишається дія зрозумілою, коли одночасно рухаються камера, люди й реквізит?

У демонстрації Continuum згенеровані зображення стають інтерфейсами, що реагують на дії. Це дослідницький показ; доступ і надійність залишаються відкритими питаннями.

Нова модель Google має конкретний зв’язок із відео: поліпшує програмне забезпечення для його відтворення. Приклад із декодером, неоднозначне порівняння з Claude й OpenAI та умови доступу до Argon.

Асистент Instagram пов’язує статистику акаунта з ідеями та сценаріями. Пояснити цифри — ще не означає довести, що порада працює.

Агенти, які працюють між розмовами, доступніша модель для складних завдань та спільний простір для людей і ШІ. Головні анонси DevDay, умови доступу й порівняння з Claude, яке має практичний сенс.

Модель для 3D-друку, ліс, написаний кодом, і цифровий скетчбук, що справді працює. Цікаві ранні експерименти із Sonnet 5.5 — з авторами, відео та поясненням результатів.

Autodesk поєднує керування 3D-сценою з ШІ-рендерингом. Задокументована демонстрація дає конкретний привід розібратися, що залишається редагованим.

Заява Anthropic про вартість, зміни API та інтерактивний проєкт Раяна Сейла про оптику. Що відомо з документації й чого не доводить окреме демо.

Три рівні моделей, різні тарифи API та опублікований проєкт у Blender. Розбираємо відмінності за спільною назвою GPT‑6.

Плагіни Runway, зміни відео за відредагованим кадром в Aleph та формати експорту: як генерація входить у звичний монтажний процес.

Генерувати й змінювати відео тепер можна просто в Premiere Pro та After Effects. Розбираю, де це справді полегшує роботу.

Архітектурний кейс Томаса Рікуара показує роботу Astra з геометрією, матеріалами, світлом і камерами у Blender.

Runway показала генеративні світи, які реагують на дії глядача. Це відкриває нові можливості — і ставить нові питання до цілісності зображення.

Довші сцени, більше референсів і звук разом із зображенням. Офіційні характеристики та результати огляду MindStudio.

InVideo пропонує багато моделей і може обирати їх автоматично. Варто розуміти, яка модель створила результат, скільки це коштує і чи можна повторити вдалу спробу.