Інструменти / Аналіз
Nemotron 3.5 Transcribe: хто що сказав, коли всі говорять одночасно
NVIDIA представляє модель на сцені з комедії 1940 року: вона розпізнає записане мовлення, позначає мовців і перекладає. Складність — правильно поєднати ці завдання.
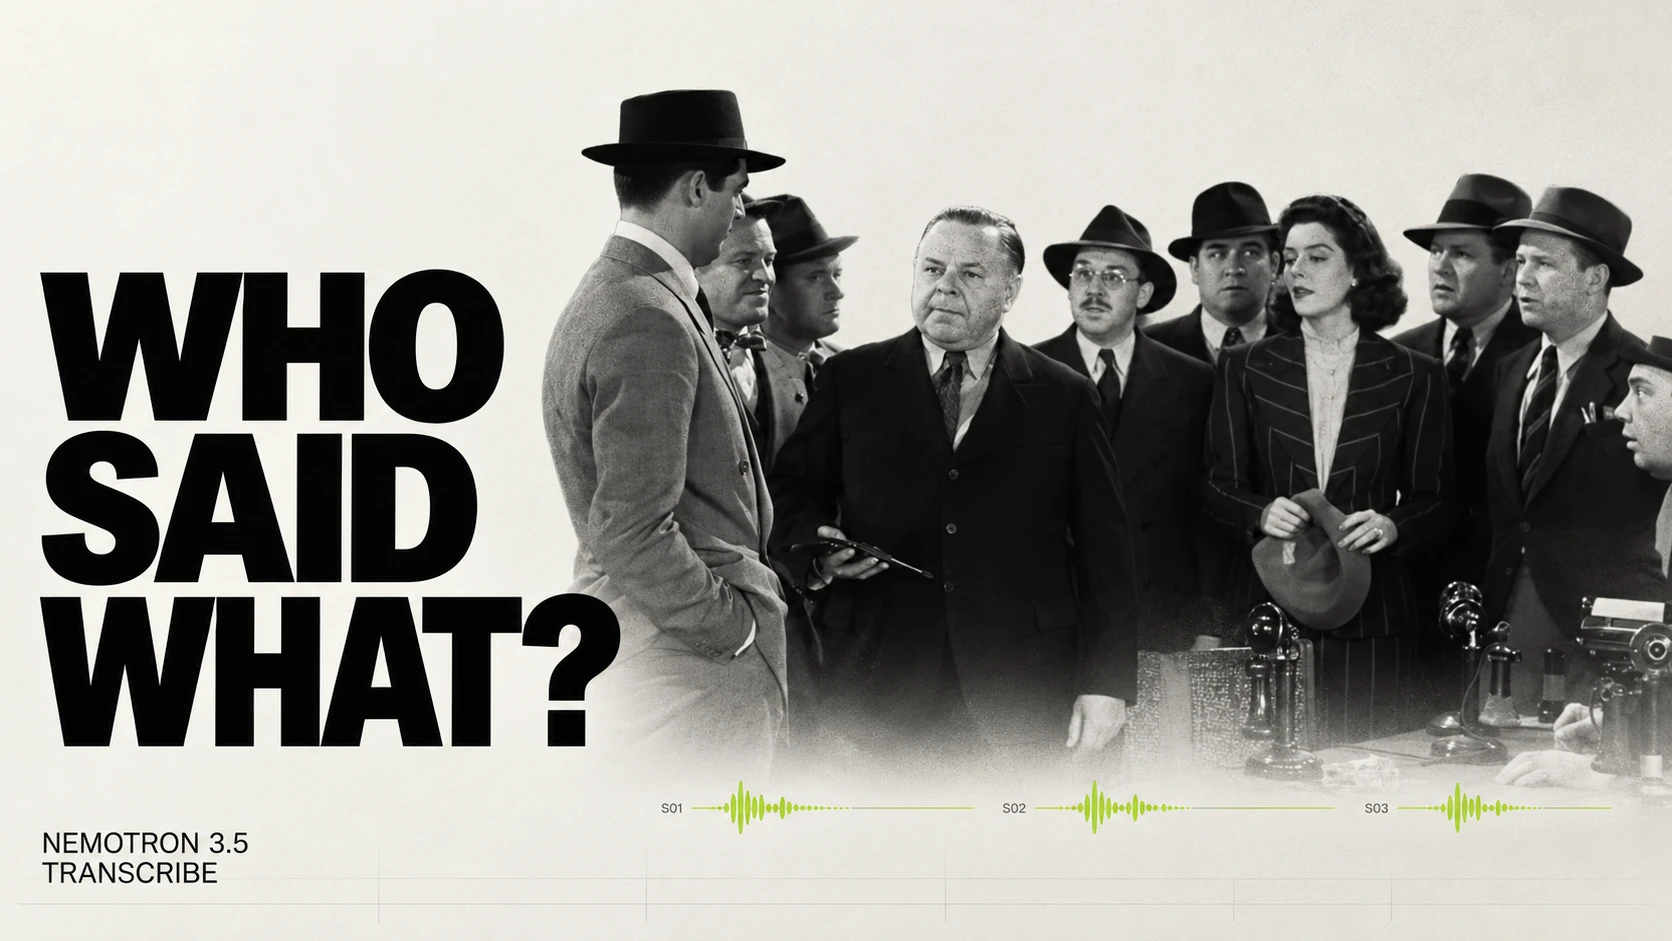

У редакції з фільму «Його дівчина П’ятниця» ніхто не чекає своєї черги. Люди перебивають одне одного, відповідають із різних кінців кімнати й починають говорити, поки попередня репліка ще триває. У демонстрації NVIDIA субтитри намагаються встигнути: слова з’являються разом із кольоровими позначками мовців, і накладання голосів стає видимим.
Цією сценою NVIDIA представляє Nemotron 3.5 Transcribe, випущену 28 жовтня. Модель із відкритими вагами приймає запис та інструкцію й повертає транскрипцію, текст із позначенням мовців, переклад або відповідь про зміст аудіо. Заявлено розпізнавання 40 мов і записів тривалістю до години. Головна обіцянка — змістовніший запис розмови: слова, час їхнього звучання й те, кому вони належать.
Сцена з фільму пояснює задачу
Комедія Говарда Гоукса 1940 року добре підходить для такої демонстрації: її діалоги не вкладаються в припущення, що люди говорять по черзі. Текст може містити правильне речення й водночас спотворювати сцену, якщо приписує його іншій людині. Діаризація визначає, хто коли говорив; транскрипція з позначенням мовців пов’язує це з конкретними словами.
За даними NVIDIA, модель може розрізняти до восьми мовців. Це позначення в межах запису, наприклад S01 та S02, а не твердження, що система знає імена акторів. У демонстрації варто стежити за обробкою перебивань; сам ролик не доводить, що кожен субтитр правильний.
Джерела: Piotr Żelasko / NVIDIA [1] · NVIDIA / Hugging Face [3] · American Film Institute [6]
«Його дівчина П’ятниця»: слова з позначенням мовців
Відібрана NVIDIA демонстрація розпізнавання одночасних реплік. Фільм: «Його дівчина П’ятниця» (1940), режисер Говард Гоукс.
Інструкція змінює транскрипцію
Transcribe враховує бажану форму тексту як частину завдання. Дослівна транскрипція зберігає слова-паразити й повтори; у тексті для читання їх можна прибрати. Список очікуваних імен або спеціальних термінів допомагає з написанням. Переклад повертає текст іншою мовою. Запитання до аудіо вимагає відповіді на основі запису. Усе це — різні результати роботи одного набору ваг.
Така гнучкість робить інструкцію редакційним рішенням. Усунення вагання може полегшити читання, але прибрати деталь, важливу для інтерв’ю чи акторського виконання. Переклад і стислий виклад мають залишатися впізнаваними перетвореннями запису. Часові позначки слів дають читачеві або редактору змогу повернутися до звуку.
Мовне покриття залежить від завдання. NVIDIA вказує 40 мов для транскрипції, 31 — для перекладу з англійської або на англійську та 13 — для атрибуції мовлення. Українська є в переліку транскрипції та перекладу через англійську, але підтримку транскрипції кількох мовців українською не зазначено. Відповіді на запитання до аудіо оцінювали англійською. Тож загальна кількість мов не описує кожну функцію.
Джерела: NVIDIA [4] · NVIDIA / Hugging Face [3]
Два типи аудіоознак для однієї мовної моделі
Архітектура поєднує енкодер мовленнєвого змісту й енкодер мовців на основі NVIDIA Sortformer. Обидва передають інформацію мовній моделі на базі Nemotron 3.5 Lightning. Ознаки мовців надходять разом з акустичним змістом, що дозволяє генерувати слова та їхню атрибуцію разом. Окремий компонент вирівнювання CTC визначає часові межі слів.
Скорочене позначення 30B/4B описує масштаб мовної моделі. З урахуванням аудіокомпонентів картка вказує приблизно 34 мільярди параметрів загалом і 4,3 мільярда активних на токен. Архітектура mixture of experts залучає лише частину ваг для кожного токена; повний набір ваг від цього не стає моделлю на чотири мільярди параметрів.
Джерела: NVIDIA [5]
Результат залежить від того, що вимірюють
В анонсі NVIDIA наведено середню частоту помилок у словах 5,33% в англомовній таблиці Open ASR — перше місце серед моделей із відкритими вагами. Картка моделі й технічний звіт публікують інше значення, 4,71%, у порівнянні на дев’яти наборах даних зі зрізом від 12 жовтня. Документи не пояснюють причину розбіжності. Ці числа слід пов’язувати з відповідними таблицями, а не подавати як взаємозамінні вимірювання.
WER рахує заміни, пропуски й вставки відносно слів еталонного тексту. Сам по собі він не показує, чи правильно визначено автора кожної репліки. Для цього у звіті також використано cpWER: спочатку зіставляються позначки мовців, потім рахуються помилки у словах. Умови запису мають значення: на зустрічах AMI NVIDIA отримала 10,29% cpWER для індивідуальних гарнітур і 17,34% для одного віддаленого мікрофона. Модель та сама; умови слухання різні.
Джерела: NVIDIA AI [2] · NVIDIA [4] · NVIDIA [5] · NVIDIA / Hugging Face [3]
Опублікований результат на момент запуску
Завантаження допису з X…
В анонсі NVIDIA наведено 5,33% WER. У статті пояснено, чому це значення не слід підміняти результатом іншого порівняння з картки моделі.
Швидка обробка все одно починається із запису
Технічний звіт повідомляє про обробку до 2 238 секунд аудіо за секунду на одній RTX PRO 6000 Blackwell Server Edition із 96 ГБ пам’яті. Це пропускна здатність конфігурації з NVFP4, спекулятивним декодуванням DFlash2 та сервером NVIDIA NIM. У тому самому дослідженні транскрипція одного 30-секундного уривка повертається за 0,13 секунди. Максимальна пропускна здатність і затримка окремого запиту описують різні режими роботи.
Transcribe працює із записаним аудіо. Ці числа не визначають, як швидко голосовий асистент почує перебивання й відповість наживо. Еталонна конфігурація BF16 передбачає H100 із 80 ГБ, а найшвидші серверні оптимізації NIM, за даними NVIDIA, ще не входять до відкритого релізу. Обладнання для розгортання варто підбирати за документацією, а не за кількістю активних параметрів.
Джерела: NVIDIA [5] · NVIDIA / Hugging Face [3]
Текст має зберігати зв’язок із голосом
Для субтитрів, інтерв’ю та записаних розмов корисне саме поєднання атрибуції, часу й контролю над формою тексту. Воно може спростити навігацію та редагування транскрипції. І дає конкретний спосіб оцінити систему: чи не губляться слова під час перебивання, чи зберігаються позначки мовців і чи можна звірити сумнівну репліку із записом?
Ці перевірки важливіші за гладенький абзац. Гарно написана транскрипція, яка передає речення іншому мовцеві, змінює розмову, яку мала зберегти.
Джерела: NVIDIA [4]
ДЖЕРЕЛА ТА МЕТОД
Що стоїть за цим матеріалом
За анонсом NVIDIA від 28 жовтня, технічним звітом, карткою моделі та документацією. Результати тестів наведено їхніми видавцями; ми не запускали модель. Уривок із фільму — демонстрація NVIDIA.
- Nemotron 3.5 Transcribe announcement and film demonstration Piotr Żelasko / NVIDIA · 2026-10-28
- NVIDIA: English Open ASR launch result NVIDIA AI · 2026-10-28
- Nemotron 3.5 Transcribe and Granary v2 NVIDIA / Hugging Face · 2026-10-28
- Nemotron 3.5 Transcribe model card and language matrix NVIDIA
- Nemotron 3.5 Transcribe Technical Report NVIDIA
- His Girl Friday (1940) American Film Institute