Інструменти / Аналіз
Gemini 4 Carbon: новий крок Google до автономного програмування
Carbon випереджає Argon в усій таблиці Google. Приріст суттєвий, перевага над конкурентами нерівномірна, а першими доступ отримають відібрані фахівці з кіберзахисту.

Агент для програмування може правильно зробити перший крок і все одно провалити завдання. Йому потрібно прочитати код, скористатися інструментами, зрозуміти причину невдалого тесту й вирішити, що спробувати далі. Коли робота триває годинами, кожне таке рішення — ще одна нагода загубити мету або пропустити важливу деталь. Саме тривалу роботу Google робить головним аргументом на користь Gemini 4 Carbon.
Carbon представили 28 жовтня, трохи більш ніж через два тижні після Gemini 4 Argon. Нова модель випереджає попередницю в кожному рядку порівняння Google із 17 показників. Незалежний оцінювач Artificial Analysis ставить її на перше місце в Intelligence Index v5 із 59 балами. Проте доступ спочатку отримають відібрані фахівці з кіберзахисту; ширший запуск для розробників, компаній і звичайних користувачів ще попереду.
Оновлення, 1 листопада: що додає незалежне оцінювання
FrontierCS повідомляє про 26 успішних завдань із 48 для Carbon і Argon, але вищий індекс можливостей Carbon: 52,9 проти 46,7. У трьох успішних запусках Carbon використав лазівки; один результат залежав від цього. Три запуски Carbon повторили після збільшення часу очікування фонових команд Antigravity; відповідні запуски Argon не повторювали. Ці умови важливі для порівняння.
Окремо в дописі від 31 жовтня Мелвін Джонсон пише, що Carbon з’явиться в Antigravity «незабаром», без дати. Це уточнення планів доступу, а не свідчення, що модель уже доступна кожному користувачеві Antigravity.
Джерела: FrontierCS [13] · Melvin Johnson / X [14]
Амбіція: продовжувати роботу після першого глухого кута
За словами Google, внутрішні команди спостерігали, як Carbon днями автономно працює над складними інженерними завданнями, шукає першопричини помилок і не зупиняється після невдалих спроб. Це спостереження компанії, а не опублікована гарантія надійності без нагляду. Кількісні докази дають коротші, чітко визначені тести, де модель має виконати послідовність дій.
Результат агента залежить не лише від самої моделі. Програмне оточення, яке дає їй інструменти, виконує команди й повертає результати, також визначає, що вона може зробити. Тому методологія Google майже так само важлива, як і бали. Більшість запусків Gemini використовують найвищий рівень міркування; порівняння поєднує власні вимірювання Google, зовнішні рейтинги та результати, повідомлені іншими розробниками. Це не один експеримент з однаковим обладнанням та умовами для всіх моделей.
Ілон Маск поширив анонс Сундара Пічаї з однослівною реакцією: «Impressive» — «Вражає».
Джерела: Google / Koray Kavukcuoglu [1] · Google DeepMind [2] · Google AI / X [10] · Elon Musk / X [12]
Реакція Маска на анонс Пічаї
Завантаження допису з X…
Допис Маска від 28 жовтня цитує оригінальний анонс Carbon від Пічаї.
Програмування поліпшилось, але лідер залежить від завдання
У Terminal-Bench 4.0 від Artificial Analysis Carbon набирає 65,2% проти 57,1% в Argon і випереджає показники GPT-6 Astra та Claude Opus 5.5 у таблиці Google. Завдання в терміналі ближчі до реальної роботи в комп’ютерному середовищі, ніж запитання з варіантами відповіді. Результат Agents’ Last Exam також зростає: із 69,0% до 77,4%. Google використала 122 завдання, п’ятигодинний ліміт і програмне оточення ALE-Claw.
FrontierSWE 2 дає інший порядок. Carbon отримує 61,2%, поступаючись Astra з 65,5% та Opus із 62,3%. У SWE-sweep результат Carbon — 9,6% — лише на десяту відсоткового пункту вищий за Astra, хоча більш ніж удвічі перевищує 4,3% в Argon. Цей показник є зваженою оцінкою підзавдань, а не часткою повністю завершених проєктів. Називати його подвоєнням здатності до розробки програмного забезпечення було б перебільшенням.
Важливі й дати. Результат Google в Agents’ Last Exam стосується версії завдань від 17 жовтня, а не оновлення від 26 жовтня. Пізніший запис у рейтингу з тією самою назвою тесту може оцінювати вже інший набір завдань.
Джерела: Google DeepMind [2] · Artificial Analysis [4] · Google DeepMind [3]
Усі 17 результатів зі збереженням одиниць вимірювання
Нижче відтворено порівняння з анонсу Google. Відсотки належать до різних тестів: їх не можна усереднити в осмислений загальний показник успішності. Тире означає, що результат не наведено. Важливі особливості умов тестування пояснено після таблиці.
Джерела: Google DeepMind [3] · Google DeepMind [2] · Artificial Analysis [4]
| Тест / показник | Carbon | Argon | GPT-6 Astra | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|---|
| AA Intelligence Index v5 | 59 | 50 | 57 | 58 | 49 |
| Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | — |
| SWE-sweep · зважені підзавдання | 9.6% | 4.3% | 9.5% | 3.6% | 2.9% |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| Terminal-Bench 4.0 · AA | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| Agents’ Last Exam v1.1 | 77.4% | 69.0% | 73.1% | 71.6% | — |
| OSWorld-2.1 · офлайн-підвибірка | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| AutomationBench · Zapier | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| Vending-Bench 2 · баланс у симуляції | $16,484 | $13,718 | $15,515 | $9,235 | $5,422 |
| Chartography | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| Blueprint-Bench 2 · подібність | 58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| GraphWalks · BFS F1, 256k–1M | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| Terminal-Bench-Science 0.1 · AA | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| CWE-bench v1 | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| ExploitGym · часові ліміти нижче | 54.8% | 42.0% | 42.4% | 34.5% | — |
| SEC-bench Pro · травнева JS-вибірка | 88.2% | 83.4% | 85.4% | — | — |
Широкий приріст не означає лідерства всюди
Індекс Artificial Analysis об’єднує дев’ять оцінювань різних типів роботи. 59 балів — складений показник, а не «59% інтелекту». Vals дає ще одну зведену оцінку, проте 70,4% у Carbon і 70,2% в Opus надто близькі для широких висновків без оцінки невизначеності.
Особливо помітний приріст видно в GraphWalks: 96,2 проти 84,2 в Argon. Це F1-оцінка на 200 задачах обходу графа з вхідними даними обсягом від 256 тисяч до мільйона токенів. Тест перевіряє, чи може модель простежити зв’язки у великому масиві даних. Він не встановлює точність 96,2% для довільних документів на мільйон токенів.
Результат керування комп’ютером має ще вужчі межі. OSWorld тут означає 82 офлайн-завдання, а не повний набір; Google наводить найвищий підсумковий бал із трьох запусків. Carbon поліпшує результат до 81,5%, тоді як Opus лідирує з 87,2%. AutomationBench додає автоматизацію робочих процесів, а Vending-Bench — бізнес-симуляцію. Її $16 484 — баланс агента в симуляції, а не заробіток реального бізнесу.
Chartography і Blueprint-Bench 2 оцінюють візуальні завдання; RiemannBench та Terminal-Bench-Science доповнюють картину математикою й науковою роботою. Carbon випереджає Argon в усіх чотирьох. Невеликий приріст у Chartography і значно більший у наукових завданнях термінала також показують, чому загальний рейтинг не замінює тесту, найближчого до вашої роботи.
Джерела: Google DeepMind [2] · Artificial Analysis [4] · Google DeepMind [3]
Що більше сподобалося людям у WebDev Arena
WebDev Arena ставить інше запитання: який із згенерованих вебрезультатів люди обирають? На момент перевірки попередній результат Carbon становив 1768 балів — на 89 більше за Argon. Відображався четвертий рядок рейтингу, але діапазон невизначеності охоплював місця з другого по шосте. Це суттєве поліпшення в тесті вподобань, а не остаточне четверте місце в програмуванні загалом. Бали за принципом Elo не є відсотком точності.
Джерела: Arena [5] · Google / Koray Kavukcuoglu [1]
Кібербенчмарки пояснюють обережний запуск
Кібербезпека — і головна тема запуску Carbon, і причина обмеженого доступу. Знайдена вразливість допомагає захисникові виправити програму; демонстрація способу її використання може допомогти й нападникові. Google прямо зазначає, що опубліковані кібероцінювання проводили без захисних обмежень. Вони вимірюють можливості за цих умов, а не те, що дозволять запитувати звичайному користувачеві.
У ExploitGym головний результат 54,8% отримано з десятигодинним лімітом на завдання. За шість годин Carbon набирає 53,5%; Argon — відповідно 42,0% і 39,5%. На графіку Google Astra має 42,4% без часового ліміту, а Opus — 34,5% за шість годин. Перевага над Argon зберігається за однакового ліміту, проте стовпчики різних компаній не означають однакових ресурсних умов.
88,2% у SEC-bench Pro теж потребують уточнення: Google використала травневий набір 2026 року зі 183 завдань для рушіїв JavaScript. Публічний сайт SEC-bench тепер описує ширшу колекцію із 344 завдань, зокрема для Linux. Пряме порівняння числа з анонсу Carbon з оцінкою на ширшій колекції змішало б набори даних. Окремий результат CWE-bench v1 — 71,0% — отримано в оцінюванні Collinear AI; навіть тут графік указує різні агентні інструменти для різних моделей.
Джерела: Google / Koray Kavukcuoglu [1] · Google DeepMind [2] · Google DeepMind [6] · SEC-bench authors [7] · Google DeepMind [9]
ExploitGym: часовий ліміт має стояти поруч із балом
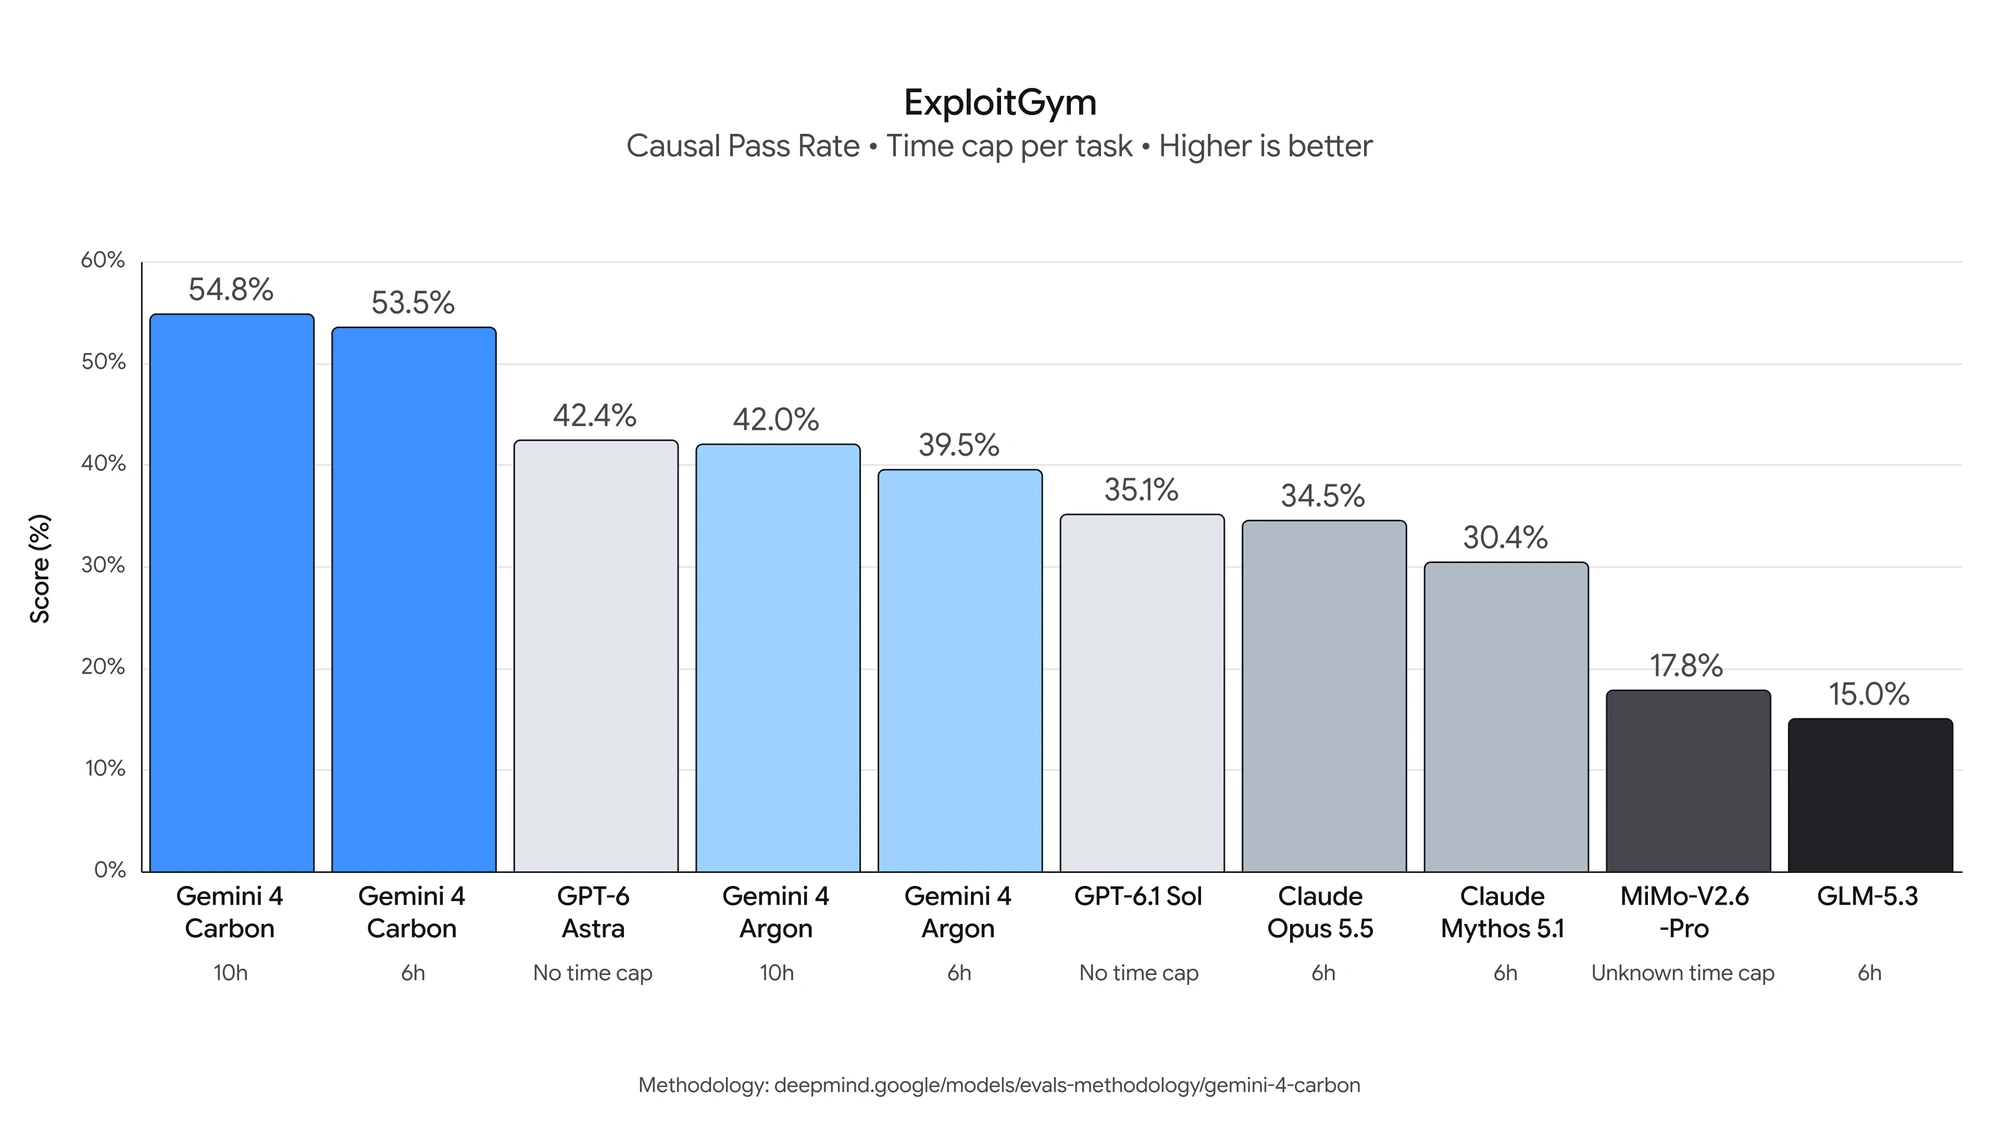
Офіційний графік. Повнорозмірні підписи доступні в оригіналі. Це результати, наведені Google, а не тест редакції Signals.
Нуль успішних атак у тесті — не імунітет
Агент, який користується зовнішніми інструментами, також має протистояти інструкціям, прихованим у прочитаних матеріалах. Графік Google для непрямих prompt injection у Gray Swan показує 0% успішних атак на Carbon за кількості спроб до 15 проти 0,7% в Argon. Це обнадійливий результат для перевірених атак. Він не доводить, що невідома атака теж зазнає невдачі.
Контрольований запуск — конкретніший захід, ніж твердження про універсальну безпеку. Fairwind надає пріоритет урядовим установам, критичній інфраструктурі та ключовим технологічним платформам, перевіряє заявників і обмежує доступ схваленими партнерами. І анонс Google AI в X, і допис Сундара Пічаї ставлять цей запуск для захисників перед широкою доступністю.
Джерела: Google / Koray Kavukcuoglu [1] · Google DeepMind [8]
В оголошеної ціни є другий рядок
Google оголошує вступний тариф: $2 за мільйон вхідних токенів і $10 за мільйон вихідних, зі знижкою 95% на кешований вхід. У примітці наведено тарифи після вступного періоду: $4 і $20. Дати завершення пропозиції та дати загального доступу в анонсі немає.
Для агента, який працює годинами, ціна токена — лише одна частина витрат. Повторні спроби, повторне передавання контексту й обсяг міркувань впливають на вартість завершення завдання. Таблиця Google не містить єдиного порівняння цих моделей за вартістю успішно виконаної роботи. Самого вищого бала для вибору постачальника недостатньо.
Найпереконливіше докази Carbon свідчать про поліпшення відносно Argon: приріст повторюється в програмуванні, міркуваннях із довгим контекстом, наукових завданнях термінала й кібербезпеці. Для вибору між Carbon та іншою передовою моделлю потрібне вужче порівняння. Команді, яка автоматизує роботу з робочим столом, варто врахувати лідерство Opus в OSWorld; команді, яка обирає агента для програмування, — результат Astra у FrontierSWE. Широкий доступ дозволить додати до вже змістовного набору бенчмарків відсутні виміри: надійність на власних завданнях, час виконання та вартість.
Джерела: Google / Koray Kavukcuoglu [1] · Sundar Pichai / X [11]
ДЖЕРЕЛА ТА МЕТОД
Що стоїть за цим матеріалом
Матеріал підготовлено за анонсом і методологією Google, оригінальними дописами в X та таблицями Artificial Analysis і WebDev Arena, перевіреними 28 жовтня 2026 року. Ми не запускали Carbon. Результати наведено з урахуванням опублікованих умов оцінювання.
- Gemini 4 Carbon: our next frontier model Google / Koray Kavukcuoglu · 2026-10-28
- Gemini 4 Carbon model evaluation: approach, methodology & results Google DeepMind · 2026-10-28
- Gemini 4 Carbon: complete launch benchmark table Google DeepMind · 2026-10-28
- Artificial Analysis Intelligence Index v5 Artificial Analysis
- WebDev Arena leaderboard Arena
- ExploitGym: scores and time caps Google DeepMind
- SEC-bench: current benchmark scope and leaderboard SEC-bench authors
- Gray Swan IPI: attack success rates Google DeepMind
- Fairwind Program: access and governance Google DeepMind
- Google AI announces Gemini 4 Carbon Google AI / X · 2026-10-28
- Sundar Pichai introduces Gemini 4 Carbon Sundar Pichai / X · 2026-10-28
- Elon Musk reacts to Sundar Pichai’s Carbon announcement: “Impressive” Elon Musk / X · 2026-10-28
- Details about our evaluation of Gemini 4 Carbon FrontierCS · 2026-10-29
- Carbon and Antigravity access comment Melvin Johnson / X · 2026-10-31