Інструменти / Аналіз
Gemini 4 Argon: ті самі кадри, швидший декодер
Нова модель Google має конкретний зв’язок із відео: поліпшує програмне забезпечення для його відтворення. Приклад із декодером, неоднозначне порівняння з Claude й OpenAI та умови доступу до Argon.

 Argon
Красивий згенерований кадр легко помітити. Програмне забезпечення, завдяки якому ми його дивимося, зазвичай залишається непомітним. Саме в ньому я знайшов найцікавіший приклад, пов’язаний із відео, в анонсі Gemini 4 Argon від Google 30 вересня.
Корисне запитання тут конкретне: чи може ШІ-агент поліпшити систему роботи з відео й водночас зберегти її результат? Для відповіді потрібні інженерні докази, а не лише переконлива демонстрація. Так у цього релізу з’являється справжній зв’язок із виробництвом відео, який можна обговорювати предметно.
Що насправді означає прискорення декодера у 2,7 раза
За даними Google, агенти Argon оптимізували наявну Rust-версію libgav1: замінили 32 тисячі рядків SIMD-коду безпечним Rust з автоматичною векторизацією. Вона стала у 2,7 раза швидшою за попередню Rust-версію, зі збереженням відеорезультату, наблизившись до оптимізованої реалізації C++.
libgav1 — декодер AV1. Декодування відновлює зображення з уже наявного стисненого відео. Генерація створює нову послідовність. Тому цей приклад не доводить прискорення генерації відео, кращої картинки чи негайного приросту швидкості у вашому монтажному застосунку. Йдеться про заявлене поліпшення конкретної програми щодо конкретної базової версії.
Для мене головне тут — збереження зображення. У виробничому інструменті прискорення втрачає цінність, якщо непомітно змінює кадр. Переконливим продовженням були б опубліковані зміни коду, тестові ролики, конфігурація комп’ютера й методика вимірювання часу. Тоді інші могли б перевірити і швидкість, і правильність. Тут ми маємо повідомлення компанії; я не відтворював її вимірювання.
Джерела: Google [1] · Google / Chromium [6]
Офіційна графіка запуску Gemini 4 Argon від Google
Оригінальна графіка видавця, без змін. Це оформлення релізу, а не скриншот експерименту з декодером.
Розуміння відео — окреме завдання
У таблиці Google Argon має 91,7% на LVBench — тесті розуміння довгих відео. Цей результат стосується інтерпретації відео, а не краси згенерованих кадрів чи монтажного смаку моделі.
Важлива й методика: Google подавав Gemini по одному кадру на секунду, а іншим моделям — обмежену кількість кадрів через ліміти API. Отже, порівняння включає відмінності у вхідних даних. Я б не сприймав його як контрольований тест з однаковим відеовходом.
Практичний тест для режисера міг би виглядати так: дати моделі готову послідовність і попросити знайти повторювану дію, указати таймкоди та пояснити сумнівний збіг. Я б додав повтор сцени, закадровий звук і деталь, яку частково приховує склейка. Це запропоновані перевірки, а не проведені мною тести Argon. Корисний помічник має показувати підстави своїх спостережень, щоб монтажер міг їх перевірити.
Джерела: Google DeepMind [2] · Google DeepMind [3]
У порівнянні з Claude й OpenAI усе залежить від завдання
У власній таблиці Google видно, чому не варто оголошувати універсального переможця. Серед наведених моделей Argon перший на DeepSWE v1.1, Astra — на FrontierSWE v2, а Opus 5.5 — на Terminal-bench 4.0. Це різні випробування; їхні відсотки не можна підміняти один одним.
У PDF із методикою розрізняються власні випробування Argon від Google та результати інших моделей із публічних рейтингів або звітів розробників. Це зведення з описаними налаштуваннями, а не новий порівняльний експеримент нашого видання. Таке уточнення має бути поруч із цифрами.
В окремій актуальній таблиці Vals AI, перевіреній 1 жовтня, Argon має 68,90%, Sonnet 5.5 — 67,04%, Opus 5.5 — 66,97%. Індекс поєднує фінансові, програмістські, юридичні й податкові завдання з економічними вагами. Він корисний для оцінювання автоматизації професійної роботи, але не вимірює режисуру, дизайнерський смак чи кіновиробництво. Пояснювальний текст сторінки ще описує попередній рейтинг на чолі з Claude, тому тут спираємося на актуальну таблицю та дату її перевірки.
Команді, яка створює інструмент для медіа, я б радив порівнювати повне завдання: правильність результату, помилки, витрачений час, людську перевірку та загальну вартість. Лідер окремого рейтингу може не підійти для вашої роботи, якщо потребує забагато нагляду.
Джерела: Google DeepMind [2] · Vals AI [5] · Google DeepMind [3]
| Тест | Argon | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | 77,9% | 74,1% | 74,2% |
| FrontierSWE v2 | 55,0% | 65,5% | 62,3% |
| Terminal-bench 4.0 | 57,4% | 58,2% | 66,4% |
Повне порівняння, опубліковане Google під час запуску
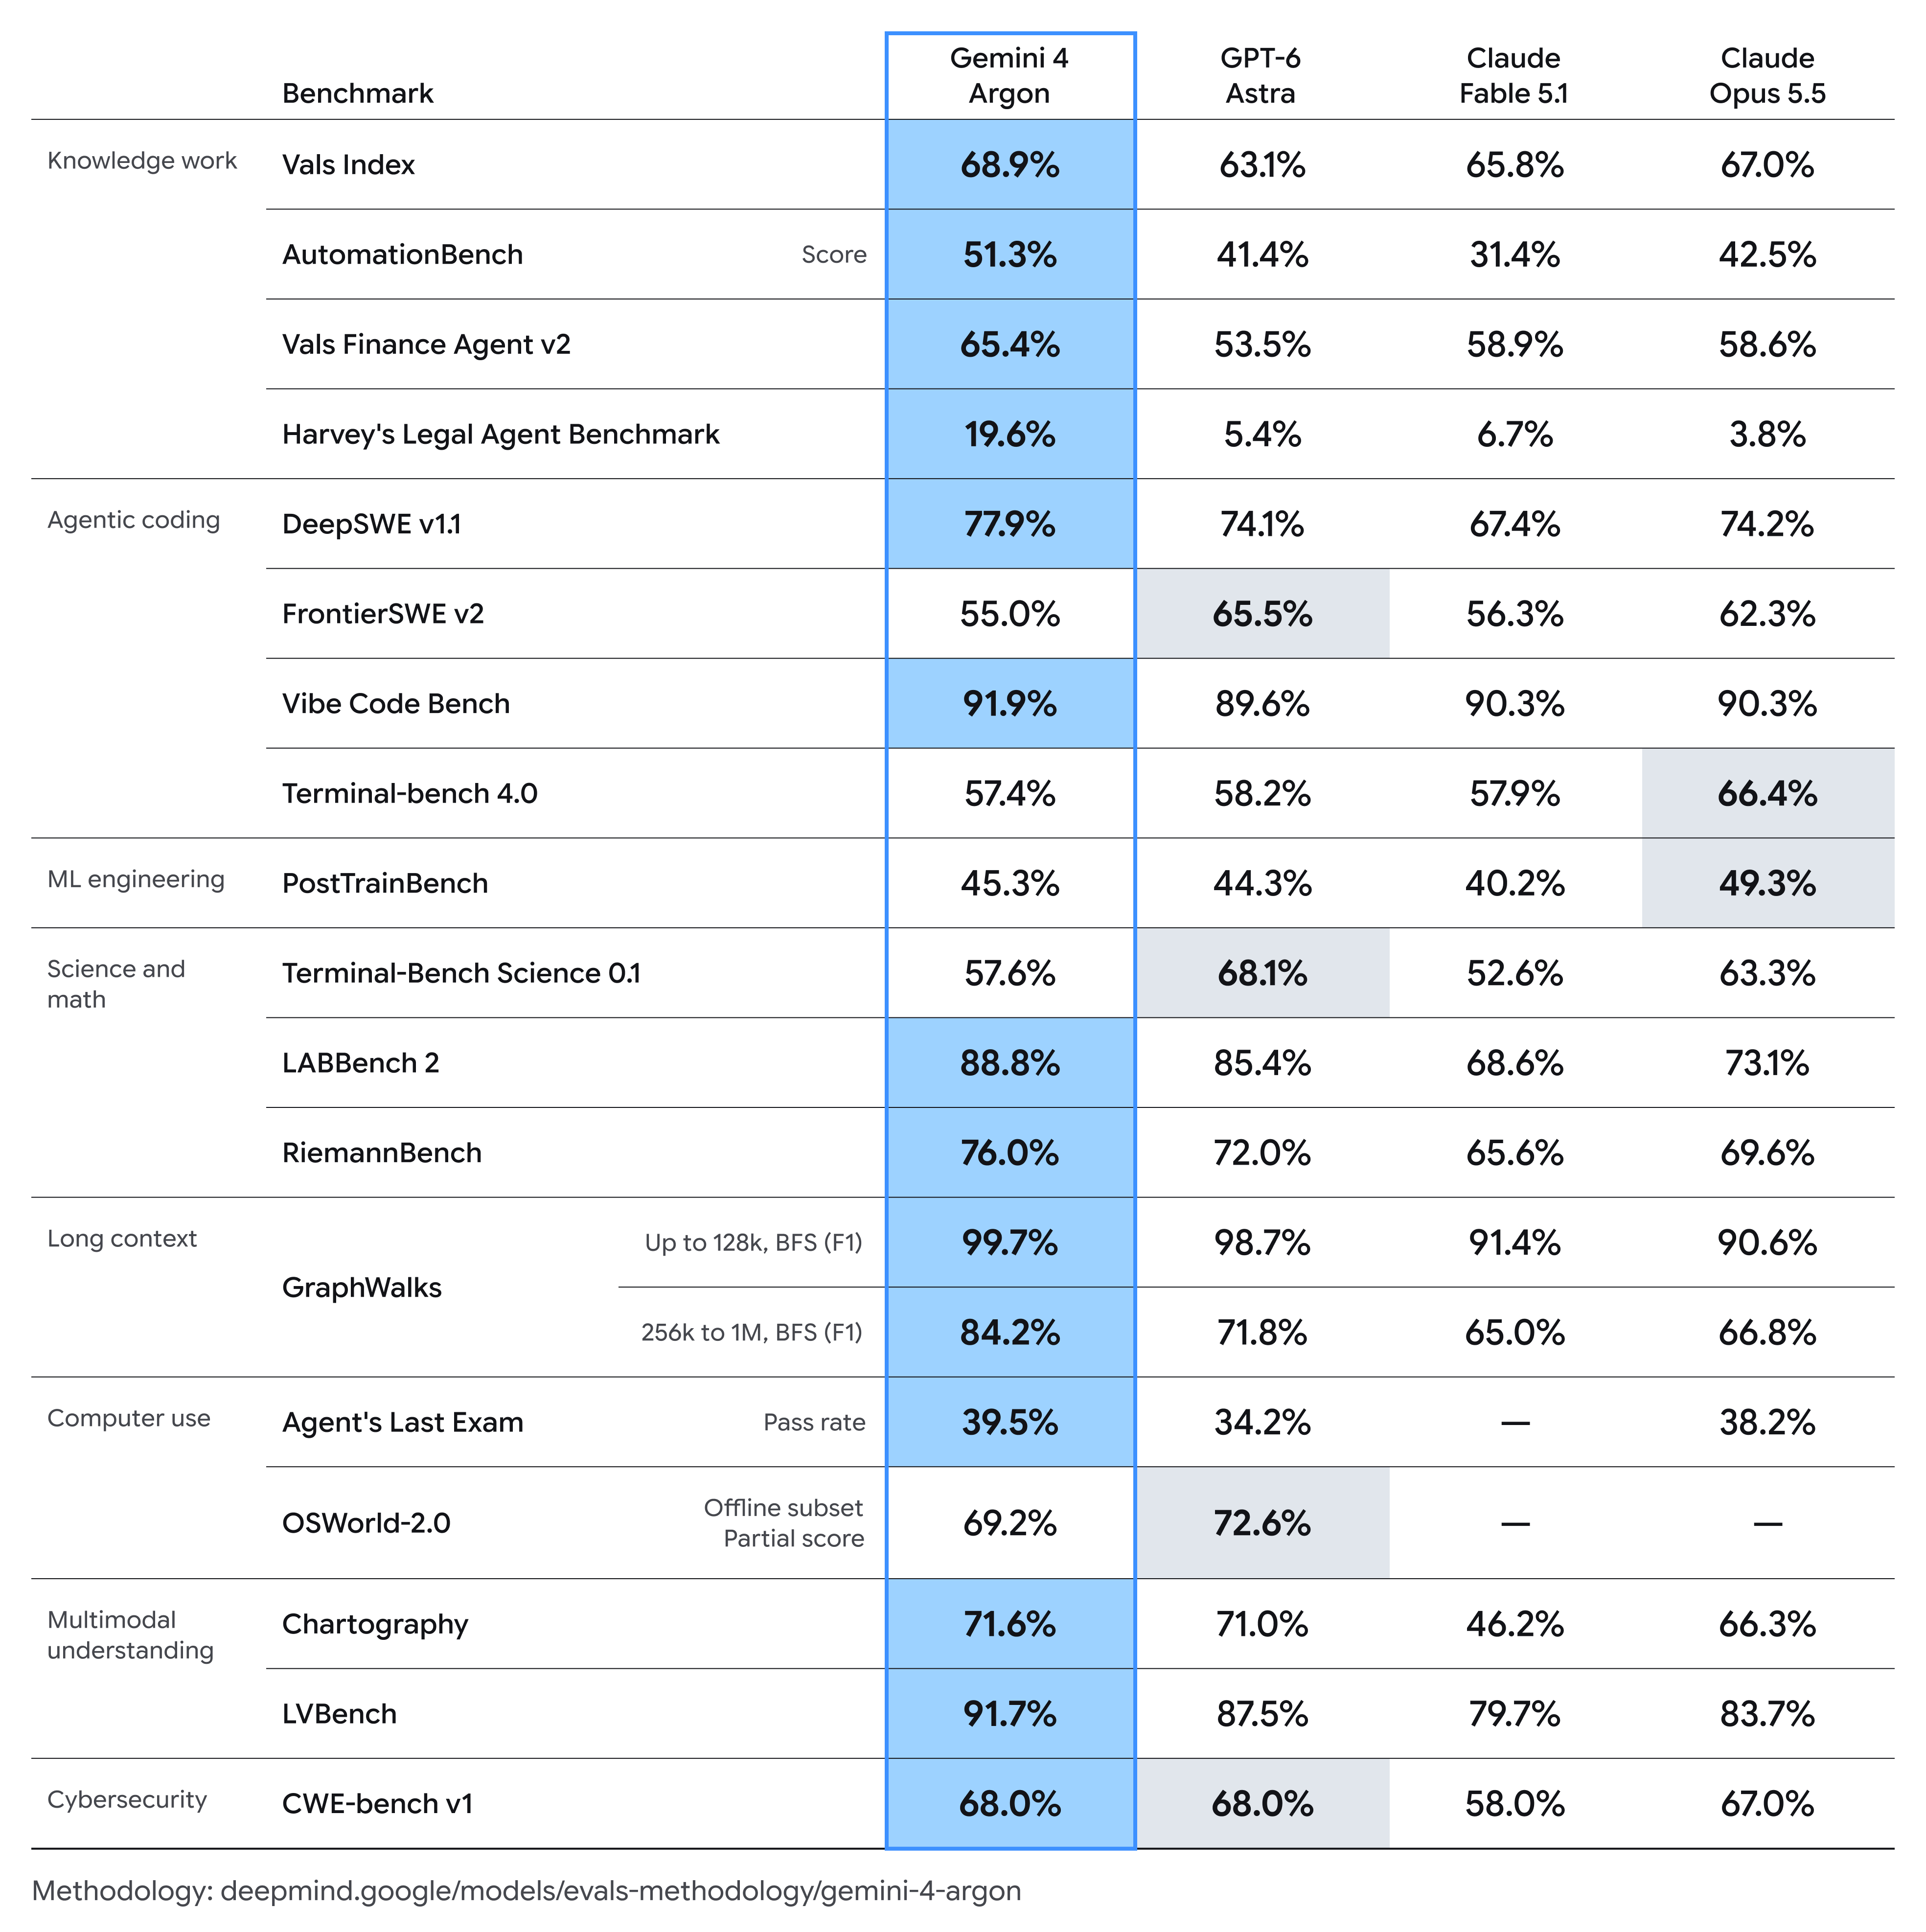
Оригінальна таблиця, без змін. Результати й налаштування випробувань належать видавцю. Компактна таблиця вище показує три різні результати; повну таблицю й методику дивіться за посиланням на джерело.
Анонс ще не означає доступ для всіх
Наразі доступ отримує обрана група довірених фахівців із кіберзахисту в Fairwind. Програма перевіряє організації та обмежує використання дозволеними захисними й дослідницькими завданнями. Це не черга раннього доступу для звичайних користувачів.
Google планує почати ширший доступ із платних клієнтів API та передплатників Google AI Ultra. Дату публічного запуску не вказано. Купівлю Ultra сьогодні не варто сприймати як підтвердження, що Argon уже доступний у вашому акаунті.
Стартова ціна тимчасова: у примітці Google вказано подальший тариф $4 за вхід і $20 за вихід на мільйон токенів. Тривалість стартового періоду не наведено. Це тарифи API, а не вартість передплати чи обіцянка конкретного ліміту використання в Ultra.
Джерела: Google DeepMind [4] · Google [1]
| Пункт | Статус |
|---|---|
| Доступ зараз | Обрані партнери Fairwind |
| Ширший запуск | Заплановано; публічної дати немає |
| Вхід / вихід API за стартовою ціною | $2 / $10 за мільйон токенів |
| Кешований вхід | Знижка 95% від ціни вхідних токенів |
| Ліміт виходу | 1 мільйон токенів; це ліміт виходу |
Що зробить цей реліз важливим на практиці
Мільйон вихідних токенів описує обсяг, який модель може видати; це не розмір вхідного контекстного вікна. Вищий ліміт також не показує, скільки ресурсів потребуватиме типовий запит. Тривалу роботу варто оцінювати за результатом і витратами на його отримання. Коротший правильний прохід може бути кориснішим за вражаюче довгий.
Коли доступ розширять, я б почав з одного проблемного компонента реального процесу, зберіг базову версію й попросив зміну, яку можна перевірити. Для відеосистеми це означає перевіряти відновлені кадри разом зі швидкістю. Для виробничого помічника — підстави кожного таймкоду. Такі тести менш видовищні за презентаційний монтаж, зате допомагають зрозуміти, чи варто включати інструмент у роботу.
Приклад із декодером цікавий мені тим, що дає конкретну точку відліку: відео залишається тим самим, а система його обробки поліпшується. Варто стежити, чи отримає ця заява продовження у вигляді коду, який можна перевірити, та ширшого доступу.
ДЖЕРЕЛА ТА МЕТОД
Що стоїть за цим матеріалом
Перевірено 1 жовтня 2026 року за оригінальним анонсом Google, сторінками моделі й Fairwind від Google DeepMind та рейтингом Vals AI. Оригінальну графіку Google й таблицю тестів переглянуто та підписано джерелами. Для статті не проводили власного випробування Argon чи вимірювання швидкості декодера. Запропоновані перевірки процесів і висновки — редакційний аналіз. Це матеріал про реліз, а не твердження про загальну доступність чи популярність у соцмережах.
- Gemini 4 Argon: our next era of frontier intelligence ↗Google · 30 Sep 2026
- Gemini 4 Argon — capabilities and evaluation table ↗Google DeepMind
- Gemini 4 Argon evaluation methodology ↗Google DeepMind
- Fairwind Program — access, governance and FAQ ↗Google DeepMind
- Vals Index v2.1 — live leaderboard and methodology ↗Vals AI · Checked 1 Oct 2026
- libgav1 — AV1 decoder source and documentation ↗Google / Chromium