Інструменти / Аналіз
NVIDIA GR00T 2 навчається робототехнічних завдань із людського відео — і покращує результат після п’яти демонстрацій
Модель NVIDIA спільно прогнозує відео та дії робота. У тесті на 50 завданнях успішність зросла з 40% без демонстрацій на цільовому роботі до 95% після п’яти прикладів на завдання й додаткового навчання.
Роботу не обов’язково бути схожим на людину, щоб навчитися на її прикладі. В одному з експериментів NVIDIA дворукий робот укладає фільтрувальний папір у лабораторну лійку та змочує його з промивалки. Завдання демонстрували люди, а не той робот, який мав його виконати. Для цієї конфігурації NVIDIA повідомляє про успіх у 65% спроб.
Цей приклад супроводжує анонс GR00T 2 від 9 листопада на Conference on Robot Learning. NVIDIA називає її моделлю світу й дій: вона разом прогнозує майбутнє відео та дії робота. Мета — навчитися передбачати, як змінюється сцена під час дії, а потім використати це для керування різними роботами.
Тут є практична різниця. Відео людської руки й команди для двигунів роботизованого захоплювача — різні дані. Якщо навичку можна перенести між ними, команді потенційно не доведеться збирати кожен приклад саме на тому роботі, який згодом виконуватиме роботу. Дослідники описують перенесення з людських демонстрацій і ручних пристроїв на інші роботизовані системи; результати стосуються конкретних завдань та обладнання NVIDIA.
Що додали п’ять прикладів
На сторінці дослідження NVIDIA описано 50 завдань, які раніше не демонстрували на цільовому роботі, хоча вони траплялися в людському відео або на інших роботах. Без демонстрацій цих завдань на цьому роботі GR00T 2 досягла 40% успіху. П’ять прикладів на кожне завдання та 30 хвилин додаткового навчання на одному RTX 5090 підвищили середній результат до 95%, повідомляють дослідники.
Ці два числа показують, що додали приклади й адаптація. Вони не доводять 95% надійності домашнього робота з довільними предметами, освітленням і перериваннями. Перед тестом модель уже мала значний обсяг попереднього навчання, а самі завдання й умови були визначені дослідниками.
В анонсі є й інший показник: без спеціальних демонстрацій система виконала хоча б раз 40 із 50 оцінюваних завдань. Виконати завдання принаймні раз і мати успіх у 40% спроб — різні вимірювання, тому ототожнювати їх не можна.
Джерела: NVIDIA Research [2] · NVIDIA [1]
Що прогнозує модель
Команда описує дифузійний трансформер, який спільно уточнює прогноз майбутнього відео й дій. Простіше кажучи, навчання пов’язує два передбачення: як може змінитися сцена і що має зробити робот. Окремі невеликі вихідні компоненти переводять цей план у команди для конкретної конструкції.
На дослідницькій сторінці NVIDIA зазначено, що попереднє навчання включало 402 730 годин людського відео від першої особи, демонстрації з ручним захоплювачем і дані роботів. Компанія відкрила доступ до частини цього людського відео обсягом 100 тисяч годин. Дослідники також описують процес, у якому людську демонстрацію спочатку відтворюють у симуляції, навчають навичку методом навчання з підкріпленням і лише потім переносять на реального робота. У прикладі з молотком симуляція є окремим етапом: це не просто «робот подивився відео й одразу опанував інструмент».
Джерела: NVIDIA Research [2]
Навичка переходить між різними захоплювачами
На дослідницькій сторінці є й інший експеримент перенесення: маніпулятор YAM збирав іграшкову вантажівку після прикладів із іншим ручним захоплювачем. NVIDIA повідомляє про 60% успішних спроб і тривалість багатокрокового завдання до чотирьох хвилин. Це демонструє можливість перенесення навички між різним обладнанням і водночас показує, що успіх окремої демонстрації не гарантує успіху кожної спроби.
Джерела: NVIDIA Research [2] · NVIDIA [1]
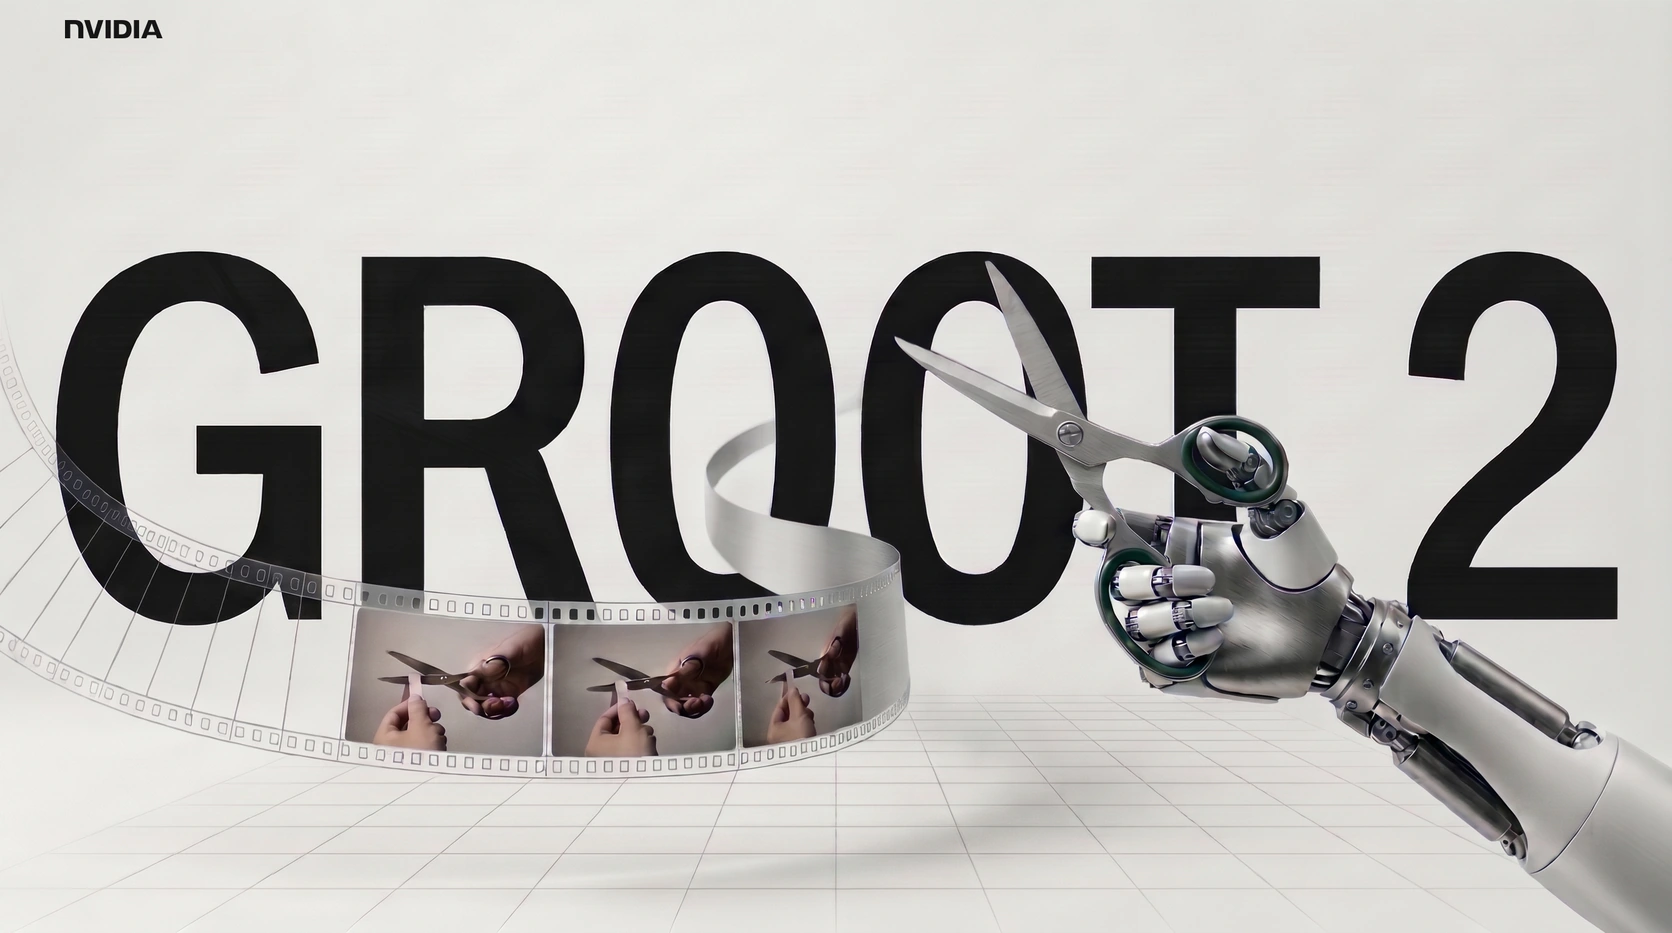
GR00T 2: демонстрація з анонсу NVIDIA
У ролику NVIDIA робот маніпулює ножицями з жовтими ручками; у вставках показано інші ракурси. Це окрема демонстрація, а не описаний тут експеримент зі складанням іграшкової вантажівки; ролик не підтверджує показник успішності того експерименту.
Що доступно командам зараз
NVIDIA називає GR00T 2 відкритою моделлю, однак сторінка дослідження зазначає: код очікується в грудні. Це майбутня дата, а не підтвердження, що весь код або ваги вже можна завантажити. Після появи репозиторію потрібно перевірити фактичний склад випуску й ліцензію.
Компанія повідомляє, що Foxconn і Siemens тестують або оцінюють систему. Це свідчення роботи з партнерами, а не доказ масштабного комерційного впровадження. Подальша перевірка — чи збережуться перенесення навичок і швидка адаптація за умов тривалої роботи поза вибраними експериментами.
Джерела: NVIDIA Research [2] · NVIDIA [1]
ДЖЕРЕЛА ТА МЕТОД
Що стоїть за цим матеріалом
Перевірено 10 листопада 2026 року за анонсом і дослідницькою сторінкою NVIDIA. Показники успішності — результати випробувань компанії на визначених роботах і завданнях. Signals не запускав модель і не відтворював ці експерименти незалежно.
- Practice Makes Precise: At CoRL, NVIDIA and Partners Reveal How Robots Rehearse Delicate Work in Simulation NVIDIA · 9 November 2026
- GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and Adaptation NVIDIA Research · November 2026